ניסוי · Rumelhart, Hinton & Williams 1986 · המודל שאומן בקוד הקורס
ציירו ספרה, והרשת שאומנה בהפצה לאחור תזהה אותה
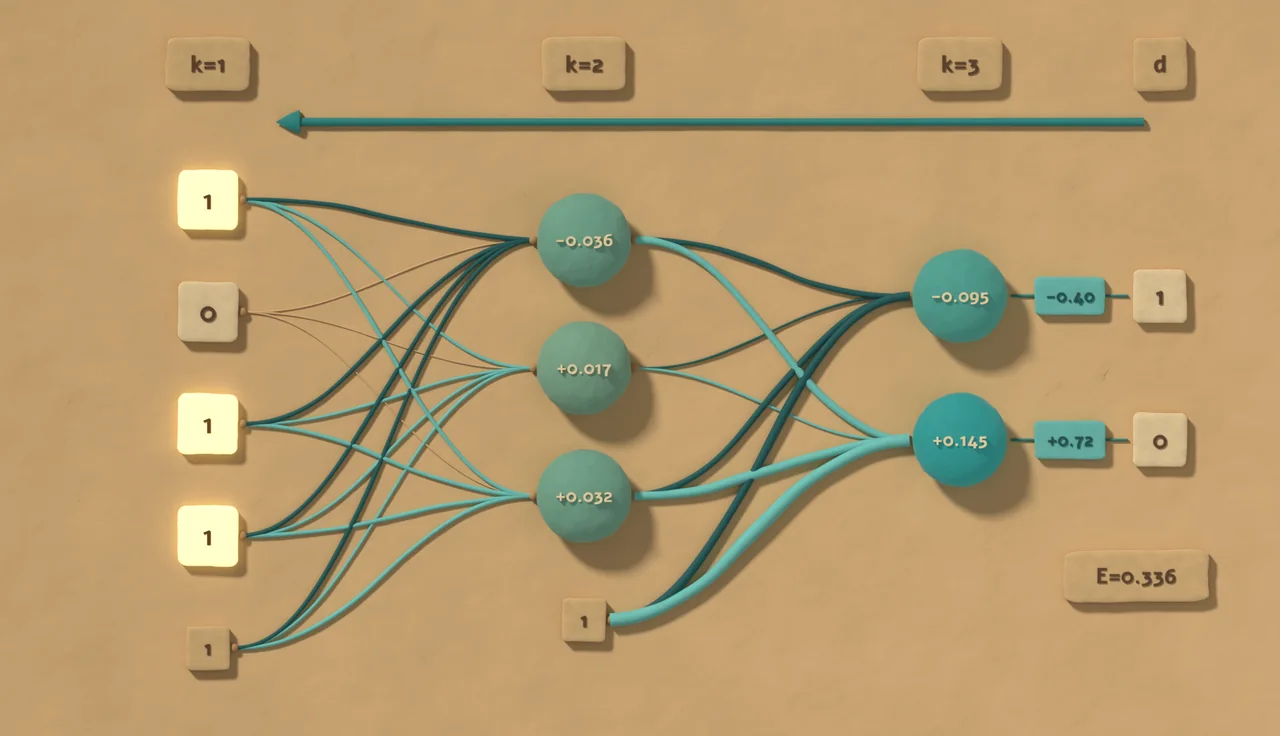
שלוש שכבות: 784 → 64 → 10, סיגמואיד בכל שכבה, משקלים שנלמדו בכלל העדכון W ← W − η∇E, קלט אחרי קלט, במעבר אחד על 60,000 ספרות בסדר שבו הן נתונות. דיוק על 10,000 ספרות בדיקה: .
ציירו ספרה
הקלט x¹
28×28, ממורכז כמו ב־MNIST, ערכים ב־[0,1]
או בחרו ספרה מהמאגר
ההחלטה
עדיין אין ציור.
הפלט y³ = σ(W²y² + b²)
עשרה מספרים ב־[0,1]; הרשת בוחרת את הגדול ביותר. ככל שהערך קרוב ל־1 הרשת "בטוחה" יותר.
השכבה החבויה y² = σ(W¹x¹ + b¹)
64 הנוירונים החבויים (כהה = קרוב ל־1). כל נוירון הוא "מבחן" שהרשת למדה בעצמה; השוו לנוירונים האקראיים של הפרספטרון.
נתונים: MNIST (LeCun, Cortes & Burges), ברישיון CC BY-SA 3.0.